Fügen Sie eine URL in die Suchleiste oben in der Google Search Console ein, und Sie erhalten ein Urteil: indexiert oder nicht, und darunter eine Menge technischer Details. Die meisten Menschen lesen nur die Überschrift und schließen den Tab. Das ist ein Fehler, denn genau in den Feldern unterhalb der Überschrift steckt die eigentliche Diagnose.
Das URL-Prüfungstool ist das Nächste, was Sie daran haben, Ihre Seite so zu sehen, wie der Googlebot sie sieht: was er gecrawlt hat, was er gerendert hat, welche kanonische URL er ausgewählt hat und ob die heutige Live-Version das behebt, was der letzte Crawl gesehen hat. Dieser Leitfaden geht Feld für Feld vor, erklärt, was jedes einzelne tatsächlich bedeutet, und liefert Ihnen die konkrete Lösung für jedes häufige Problem, das dabei ans Licht kommt.
Was das URL-Prüfungstool Ihnen tatsächlich zeigt
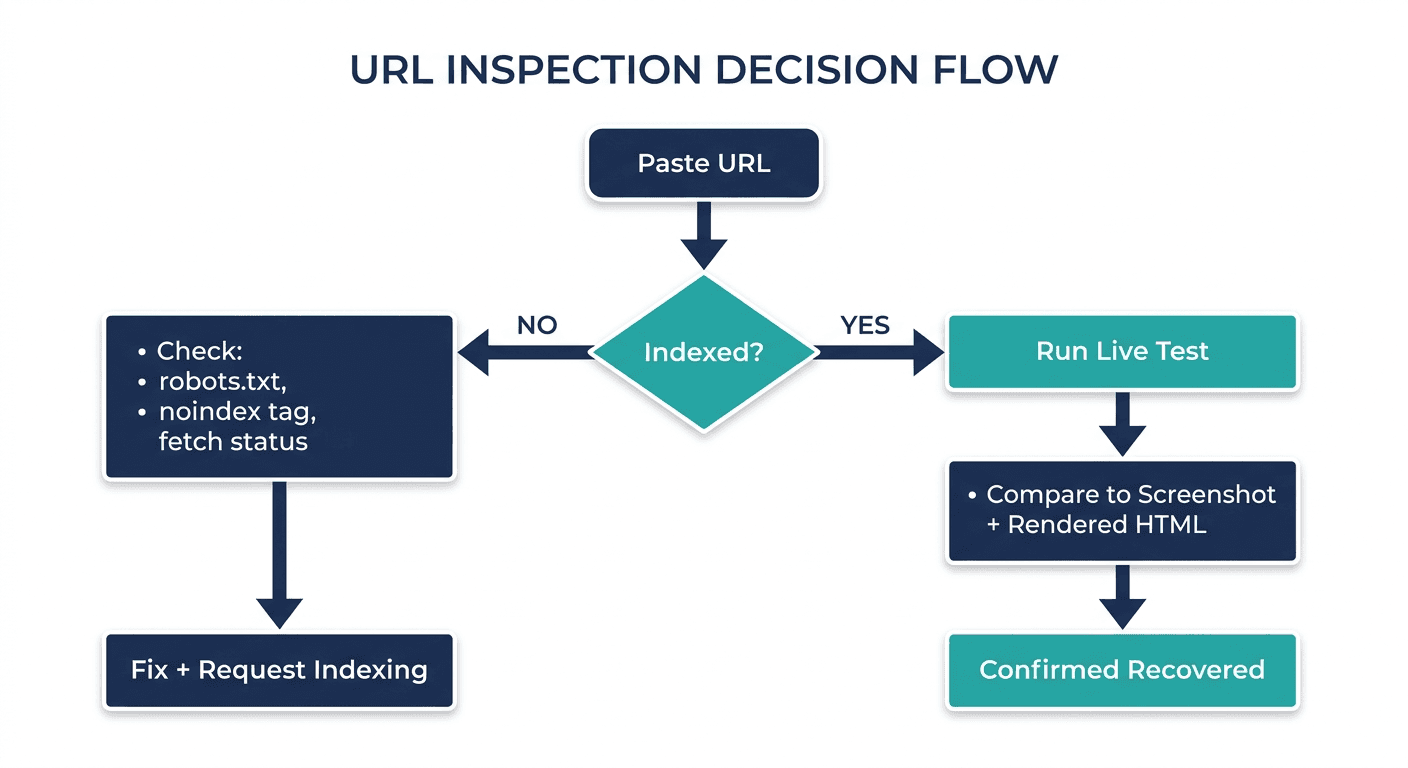
Öffnen Sie die Search Console, fügen Sie eine vollständige URL in die Prüfleiste oben ein und drücken Sie die Eingabetaste. Sie erhalten eines von zwei Ergebnissen:
- URL ist auf Google. Die Seite ist indexiert und kann in den Suchergebnissen erscheinen.
- URL ist nicht auf Google. Die Seite ist nicht indexiert, und die Search Console nennt Ihnen ungefähr den Grund dafür.
Diese Überschrift ist der am wenigsten nützliche Teil des Berichts. Die eigentliche Information steckt in zwei Abschnitten darunter: Seitenindexierung (was beim letzten Crawl der Seite durch Google passiert ist) und Live-Test (was passiert, wenn Sie Google bitten, die aktuelle Version jetzt sofort zu prüfen).
Hier erfahren Sie, was jedes Feld im Abschnitt Seitenindexierung bedeutet und was zu tun ist, wenn es ein Problem meldet.
| Feld | Was es Ihnen sagt | Was zu tun ist, wenn es ein Problem gibt |
|---|---|---|
| Erkennung | Wie Google die URL gefunden hat: eine Sitemap, eine verweisende Seite oder "nicht gemeldet" | Wenn eine Seite, die Ihnen wichtig ist, nie gefunden wurde, nehmen Sie sie in Ihre Sitemap auf und verlinken Sie von einer bereits indexierten Seite darauf |
| Letzter Crawl | Das genaue Datum und die Uhrzeit des jüngsten Crawls durch Google | Wenn dies alt ist und sich die Seite seitdem geändert hat, führen Sie einen Live-Test durch und beantragen Sie die Indexierung |
| Gecrawlt als | Welcher Googlebot-User-Agent die Seite gecrawlt hat (meist mobil) | Probleme mit abweichendem Rendering lassen sich oft darauf zurückführen, was dieser Bot gesehen hat im Vergleich zu dem, was ein Desktop-Besucher sieht |
| Crawling zulässig? | Ob die robots.txt das Crawlen dieser URL erlaubt | "Nein: durch robots.txt blockiert" bedeutet, dass Sie die robots-Regel beheben müssen, nicht den Seiteninhalt |
| Seitenabruf | Ob Google die Seite tatsächlich abrufen konnte (Erfolg, 404, Soft 404, Weiterleitungsfehler, Crawling-Anomalie) | Ein fehlgeschlagener Abruf ist ein Server- oder Hosting-Problem, kein Inhaltsproblem; prüfen Sie Server-Logs und Antwortcodes direkt |
| Indexierung zulässig? | Ob ein Meta-Robots-Tag oder ein HTTP-Header die Indexierung blockiert | Ein versehentliches noindex, das aus einer Staging-Umgebung übrig geblieben ist, gehört zu den häufigsten stillen Traffic-Killern auf dieser Liste |
| Vom Nutzer angegebene kanonische URL | Die kanonische URL, die Sie in Ihrem Code angegeben haben | Bestätigen Sie, dass sie mit der Seite übereinstimmt, die Sie tatsächlich ranken lassen wollen |
| Von Google ausgewählte kanonische URL | Die kanonische URL, die Google gewählt hat und die von Ihrer abweichen kann | Eine Abweichung hier bedeutet meist doppelten oder nahezu doppelten Inhalt, der Google verwirrt, welche Version ranken soll |
Zwei Zeilen sind es wert, zweimal gelesen zu werden. Erstens: "URL ist auf Google" bedeutet, dass die Seite erscheinen kann, nicht, dass sie derzeit für irgendetwas rankt. Berechtigung und Leistung sind zwei verschiedene Fragen; die Ranking-Daten im Leistungsbericht der Search Console beantworten die zweite. Zweitens: Der Abschnitt Seitenindexierung spiegelt den letzten Crawl wider, der Tage oder Wochen alt sein kann. Wenn Sie heute etwas behoben haben, zeigt dieser Abschnitt es erst, wenn Google die Seite erneut crawlt, und genau dafür ist der Live-Test da.
Einen Live-Test durchführen (und warum er sich vom indexierten Bericht unterscheidet)
Klicken Sie auf "Live-URL testen", und die Search Console ruft die Seite jetzt sofort live ab, genau so, wie es der Googlebot tun würde. Das ist die einzelne nützlichste Schaltfläche im Tool, denn sie erlaubt Ihnen zu bestätigen, dass eine Korrektur funktioniert hat, bevor Sie tagelang auf einen erneuten Crawl warten, der den indexierten Bericht aktualisiert.
Ein Live-Test liefert Ihnen:
- Echtzeit-Crawlbarkeit und -Indexierbarkeit, geprüft an der aktuellen Seite, nicht am letzten Crawl.
- Gerendertes HTML, das DOM, nachdem der Googlebot Ihr JavaScript ausgeführt hat. Hier fangen Sie Inhalte ab, die erst nach einem clientseitigen Rendering erscheinen, das der Googlebot nicht abschließen konnte.
- Ein Screenshot davon, wie der Googlebot die Seite visuell gerendert hat. Wenn Ihr Screenshot einen leeren Hero-Bereich oder fehlende Inhalte zeigt, die ein menschlicher Besucher problemlos sieht, ist diese Lücke mit bloßem Auge im Browser unsichtbar und erscheint nur hier.
- JavaScript-Konsolenfehler, die während des Live-Renderings erfasst werden und defekte Skripte ans Licht bringen, die auch eine normale Browser-Konsole melden würde, die Sie aber wahrscheinlich noch nie aus Googles Perspektive geprüft haben.
- Seitenressourcen, eine vollständige Liste aller angeforderten CSS-, JS-, Bild- und Schriftartdateien, jeweils gekennzeichnet als geladen, blockiert oder fehlgeschlagen. Eine blockierte Ressource hier (häufig eine in der robots.txt verbotene JS-Datei) kann das Rendering einer Seite, die für Sie völlig normal aussieht, unbemerkt zerstören.
- Validierung strukturierter Daten, die jeden von Google erkannten Schema-Typ auflistet und angibt, ob er gültig ist, Warnungen enthält oder Fehler aufweist.
- Vollständige HTTP-Antwort-Header, einschließlich Statuscode,
X-Robots-Tag, Cache-Anweisungen und Content-Type.
Wenn der Live-Test sauber zurückkommt und der indexierte Bericht weiterhin ein Problem zeigt, ist diese Lücke selbst diagnostisch: Sie bedeutet, dass Sie das Problem bereits behoben haben und nur noch auf einen erneuten Crawl warten. Das ist der Moment, um "Indexierung beantragen" zu nutzen, was Google bittet, einen frischen Crawl dieser bestimmten URL zu priorisieren. Es ist keine Garantie für eine sofortige Neuindexierung und nicht für den Masseneinsatz über Dutzende von URLs gedacht, aber für eine einzelne wichtige Seite nach einer echten Korrektur ist es das richtige Werkzeug.
Fünf praktische Anwendungsfälle
1. Bestätigen Sie, dass eine Korrektur tatsächlich funktioniert hat, bevor Sie auf einen erneuten Crawl warten. Sie haben ein kanonisches Tag korrigiert, ein versehentliches noindex entfernt oder eine Ressource in der robots.txt freigegeben. Anstatt abzuwarten, ob sich der indexierte Bericht irgendwann aktualisiert, führen Sie den Live-Test sofort durch. Kommt er sauber zurück, beantragen Sie die Indexierung und machen mit Gewissheit statt mit einer Vermutung weiter.
2. Erkennen Sie eine Abweichung der kanonischen URL, bevor sie Sie eine rankende Seite kostet. Wenn "Vom Nutzer angegebene kanonische URL" und "Von Google ausgewählte kanonische URL" nicht übereinstimmen, teilt Google Ihnen mit, dass es eine andere URL für die maßgebliche Version dieses Inhalts hält, oft wegen doppelter oder dünner Inhalte über nahezu identische Seiten hinweg. Das lohnt sich zu prüfen, sobald zwei URLs auf Ihrer Website plausibel dieselbe Suchanfrage bedienen könnten.
3. Beheben Sie eine Seite, die für Menschen einwandfrei rendert, aber nicht für den Googlebot. Vergleichen Sie das gerenderte HTML und den Screenshot im Live-Test mit dem, was Sie in einem echten Browser sehen. Ein Inhaltsblock, der von einem langsamen API-Aufruf abhängt, ein durch die robots.txt blockiertes Skript oder ein clientseitiges Rendering, das abläuft, bevor der Googlebot das Warten aufgibt, zeigen sich alle als Lücke zwischen dem, was eine Person sieht, und dem, was der Screenshot zeigt.
4. Diagnostizieren Sie, warum eine bestimmte wichtige Seite nicht indexiert ist. Arbeiten Sie die Felder der Seitenindexierung der Reihe nach ab: Wurde sie erkannt, war das Crawling erlaubt, war der Abruf erfolgreich, ist die Indexierung erlaubt, verweist die kanonische URL dorthin, wo Sie es erwarten. In neun von zehn Fällen liegt die Antwort im ersten Feld, in dem etwas nicht stimmt.
5. Erkennen Sie ein Muster über mehrere Seiten hinweg, nicht nur bei einer URL. Das Tool prüft immer nur eine URL auf einmal, aber wenn Sie bei mehreren geprüften Seiten dieselbe Antwort erhalten (durch robots.txt blockiert, unerwartete kanonische URL, fehlgeschlagener Abruf), handelt es sich um ein websiteweites Konfigurationsproblem, nicht um vier voneinander unabhängige Zufälle. Ein falsch konfiguriertes CMS-Template oder eine robots.txt-Regel, die breiter greift als beabsichtigt, erklärt ein wiederkehrendes Muster meist schneller als vier einzelne, isolierte Fehler.
Was das Tool Ihnen nicht sagen kann
Drei Grenzen sollten Sie kennen, bevor Sie sich für etwas darauf verlassen, wofür es nicht gebaut wurde:
- Es ist kein Ranking-Tool. "URL ist auf Google" ist ein Ja/Nein zur Berechtigung. Es sagt Ihnen nichts über Position, Impressionen oder Klicks für ein Keyword. Dafür brauchen Sie den Leistungsbericht, gefiltert nach Seite, der die eigentliche Quelle dafür ist, ob eine Seite im Lauf der Zeit an Sichtbarkeit gewinnt oder verliert.
- Es prüft immer nur eine URL auf einmal. Es gibt in der Oberfläche keinen Massenmodus, um Dutzende von URLs auf einmal zu prüfen (dafür existiert die URL Inspection API mit eigenem Tageskontingent, und sie ist ein entwicklerorientiertes Werkzeug statt etwas, das Sie im Dashboard durchklicken).
- Eine weiterleitende URL berichtet über das Original, nicht über das Ziel. Wenn Sie eine URL prüfen, die per 301 woanders hin weiterleitet, beschreibt der Bericht den Status der ursprünglichen URL. Sie müssen das Ziel separat prüfen, um zu sehen, wie diese Seite tatsächlich indexiert ist.
Nichts davon macht das Tool weniger nützlich. Es bedeutet nur, dass es die Frage "Kann Google diese bestimmte Seite sehen und indexieren" beantwortet und nichts darüber hinaus. Kombinieren Sie es für Ranking-Fragen mit dem Leistungsbericht und für websiteweite technische Audits mit einem Crawler wie Screaming Frog.
Wo dies in einen größeren SEO-Workflow passt
Das URL-Prüfungstool beantwortet eine enge, spezifische Frage gut: Ist diese eine Seite crawlbar, renderbar und so indexiert, wie ich es erwarte. Das macht es zur richtigen ersten Anlaufstelle, wenn eine Seite plötzlich nicht mehr auftaucht oder wenn Sie gerade eine Korrektur ausgeliefert haben und einen Beweis wollen, bevor Sie weitermachen.
Es ist jedoch nicht dafür gebaut, Ihre gesamte Website für Sie zu überwachen, und Seiten einzeln zu prüfen skaliert nicht mehr, sobald Sie mehr als eine Handvoll URLs verwalten. Genau um diese Lücke ist Murkuz herum gebaut: Statt nach jeder Inhaltsänderung manuell URLs in die Search Console einzufügen, ruft Murkuz Ihre GSC-Daten automatisch jeden Tag ab und markiert nachlassende Seiten, bevor Sie überhaupt daran denken würden, sie einzeln zu prüfen. Wird eine Korrektur veröffentlicht, bestätigt derselbe tägliche GSC-Abruf, ob sich die Seite tatsächlich erholt hat, sodass Sie sich nicht auf Ihr Gedächtnis verlassen müssen, um sie ein paar Wochen später erneut zu prüfen.
Wenn Sie bereits sicher darin sind, einzelne Prüfungen von Hand durchzuführen, und sehen möchten, wie die vernetzte Version über eine ganze Website hinweg statt einer URL nach der anderen funktioniert, führt die Seite zur Search-Console-Integration genau durch, welche Daten einfließen und was Murkuz damit macht.
FAQ
Was macht das URL-Prüfungstool?
Es zeigt Ihnen, wie die Systeme von Google eine bestimmte URL sehen: ob sie indexiert ist, wann sie zuletzt gecrawlt wurde, ob Crawling und Indexierung erlaubt sind, welche kanonische URL Google ausgewählt hat und welche strukturierten Daten erkannt wurden. Es bietet außerdem einen Live-Test, der die aktuelle Version der Seite in Echtzeit prüft, getrennt vom indexierten Bericht.
Wie prüfe ich, ob eine URL indexiert ist?
Fügen Sie die vollständige URL in die Prüfleiste oben in der Search Console ein. Sie erhalten "URL ist auf Google", wenn sie indexiert und berechtigt ist, in der Suche zu erscheinen, oder "URL ist nicht auf Google" mit einem Grund, wenn nicht. Denken Sie daran, dass "auf Google" bedeutet, dass sie erscheinen kann, nicht, dass sie derzeit rankt; für tatsächliche Ranking-Daten nutzen Sie den Leistungsbericht, gefiltert auf diese Seite.
Warum zeigt Google eine andere kanonische URL an als die, die ich festgelegt habe?
Google wählt eine eigene kanonische URL, wenn es glaubt, dass eine andere URL denselben Inhalt besser repräsentiert, was meist bei doppelten, nahezu doppelten oder dünnen Inhalten über mehrere URLs hinweg passiert. Prüfen Sie, ob sich die von Google ausgewählte Seite wirklich mit Ihrer überschneidet; falls ja, konsolidieren Sie den Inhalt oder korrigieren Sie Ihre kanonischen Tags so, dass sie mit Googles Einschätzung der Lage übereinstimmen.
Wie lange dauert es, bis "Indexierung beantragen" wirkt?
Es gibt keinen festen Zeitrahmen. Es bittet Google, einen erneuten Crawl dieser URL früher zu priorisieren als sonst, garantiert aber keine sofortige Neuindexierung, besonders bei Websites, die Google selten crawlt. Am besten funktioniert es bei einer einzelnen wichtigen Seite nach einer echten Korrektur, nicht als Möglichkeit, viele URLs auf einmal in den Index zu zwingen.
Kann ich mehrere URLs gleichzeitig prüfen?
Nicht in der Search-Console-Oberfläche, die immer nur eine URL pro Anfrage prüft. Google bietet eine separate URL Inspection API mit einem Tageskontingent für programmatische Massenprüfungen, was ein Entwicklerwerkzeug ist statt etwas, das Sie direkt im Dashboard verwenden.
Junaid Khalid ist der Gründer von Ertiqah und der Entwickler von Murkuz. Er hat SEO als ersten Wachstumskanal über seine eigenen SaaS-Produkte hinweg betrieben, was viele Stunden bedeutet, die er genau hier verbracht hat, eine URL nach der anderen in der Search Console, bevor er die Teile dieser Routine automatisierte, die es wert waren, automatisiert zu werden.